
科研前沿
科研前沿
数学的黄金时代与数学家的失落时代
作者简介:
魏哲巍,7M体育即时比分 教授、博士生导师、国家高层次人才,现任7M体育即时比分 副院长、新一代智能搜索与推荐教育部工程研究中心副主任。2008年本科毕业于北京大学数学科学学院,2012年博士毕业于香港科技大学计算机系。主要研究方向为人工智能与大数据基础算法,主持国家自然科学基金重点项目等,指导学生获百度奖学金、微软学者、CCF优秀博士学位论文等荣誉。
引言
近年来,以大语言模型为代表的人工智能技术飞速发展,其影响已经从信息处理、内容生成等领域,逐步深入到科学研究的核心环节。数学作为最古老、也最依赖人类抽象思维能力的学科,正在成为这一轮技术变革冲击最为直接的领域之一。
近期发生的几件事情值得关注。9 月 8 日,OpenAI 宣布其内部模型构造出带光滑外力的三维纳维–斯托克斯方程的有限时间爆破解,称这解决了千禧年问题的相应版本,并称证明已经 Lean 形式化验证;该结果的来源目前尚有争议。10 月 6 日,OpenAI 一次性公开了 722 篇由该模型生成的数学手稿,归为 372 组;据其披露,这些结果出自研究人员提交给模型的约 4000 个未解研究问题,平均每个结果耗费的算力约相当于 ChatGPT Pro 思考三小时。其中一组手稿处理的是另一个千禧年问题霍奇猜想的若干特殊情形;这不等于一般的霍奇猜想已经解决,目录中也未见这一组配套的形式化证明。
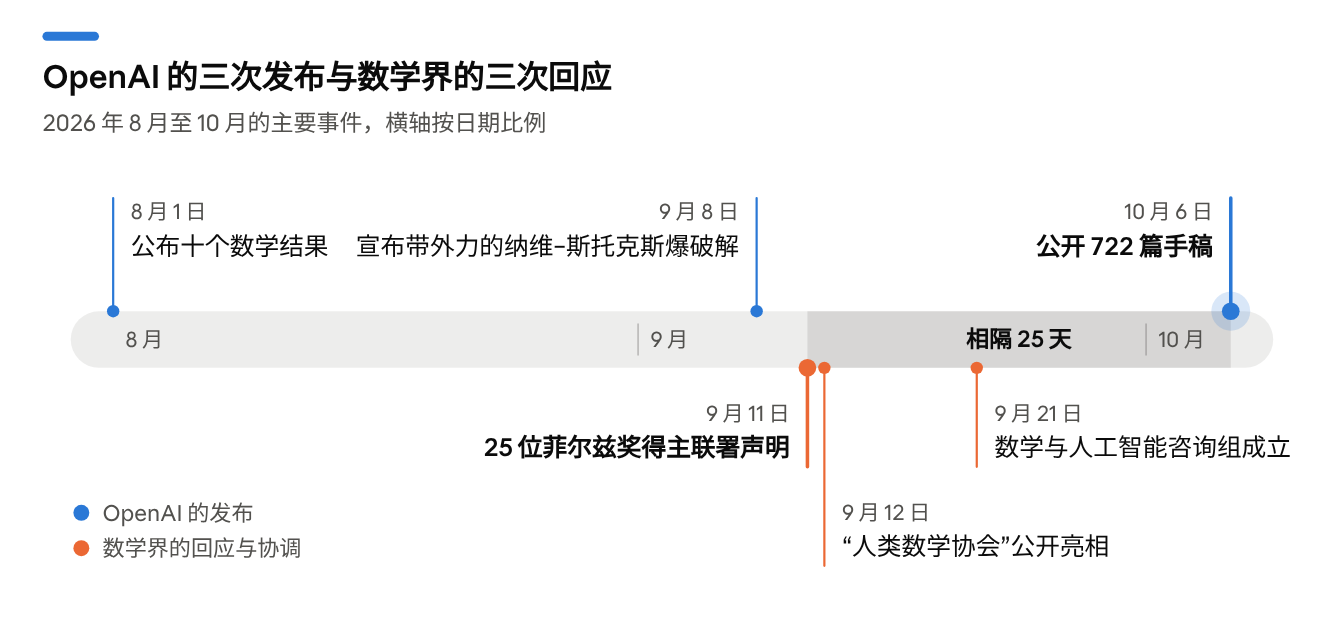
图 1 2026 年 8 月至 10 月的主要事件。
日期据 OpenAI 公告及媒体报道
康奈尔大学应用数学家 Steven Strogatz 在接受 WIRED 采访谈及这些进展时,一度落泪。这位六十七岁的学者说,科学本身令人振奋,但随之而来的是许多人感到的不安;2026 年将被记住,或者作为数学的奇迹之年,或者作为灾难之年。
笔者以为,这两者很可能是同一年。基于对技术发展态势的观察和自身的实践体验,笔者作出如下判断:在证明这一端,人工智能系统已经越过辅助计算和偶尔解题的阶段,能够在较少人工干预的情况下成规模地产出前沿结果;在提出问题、给出新定义这一端,同样的变化也将在不长的时间内出现。
职业声望的变化会较快显现;研究经费和岗位的调整则受资助周期与招聘周期制约,显现得慢一些。
可以说,数学有可能因此进入一个空前繁荣的时期。然而,数学家未必能够自动分享这份繁荣。本文试图从几个不同的视角,对这一判断的依据及其可能的后果作一些初步的分析。
一、从证明的本质看:证明即搜索
上述判断主要基于两方面的考虑。
其一是笔者自身的实践体验。这里举一个例子。Tusnády 问题是组合差异理论中的一个经典问题,其平面情形的上下界之间有一个四十多年没有合上的缺口。Nikhil Bansal 在 2022 年国际数学家大会(ICM)的报告文章中,仍将弥合这一问题上下界之间的差距列为重要开放问题。今年,笔者借助大语言模型,用非常简单的证明解决了这个问题,论文已在 arXiv 公开(arXiv:2610.08130)。
这个问题可以直观地理解为:把平面上的 n 个点染成红、蓝两色,能否让每个横平竖直的矩形内,两种颜色的点数都尽量接近?
此前已知,总能把最大差额控制在 (log n)3/2 的量级,但只知道某些点集无论怎样染色,都会留下至少 log n 量级的差额。这项工作补上了这个缺口,而且发现:要构造最难染色的点集,无须精巧设计,均匀随机撒点就以极高概率达到最优量级。证明也出乎意料地简单,只用初等的组合与概率论证:设计一个衡量局部振幅的量,逐层揭示点的位置,累积条件期望中的增益,再控制随机波动。
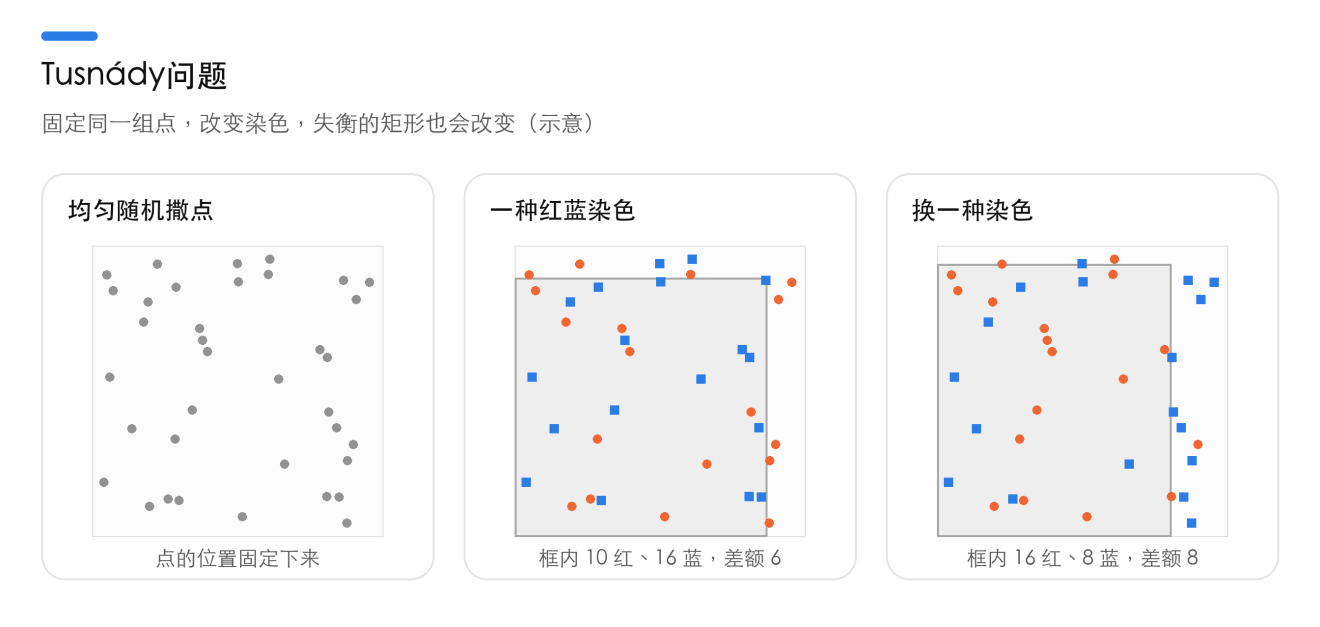
图 2 随机点与矩形内的红蓝差额。
中、右图展示同一点集的两种染色及各自的一个失衡矩形。这里只作示意;定理保证的是,随机点集以极高概率对所有染色都存在差额达到最优量级的矩形。
笔者自 2013 年起思考这个问题,今年 7 月开始与 GPT、Claude 持续交互,反复探索思路、寻找漏洞,将最初较复杂的证明简化成现在的论证,并借助 AI 完成主要下界定理的 Lean 形式化验证。核心思路形成于这一交互过程;笔者负责提出问题、判断方向、核对论证。这已经很难再称之为“辅助”。
其二是对数学研究本质的认识。培根强调,科学发现要靠归纳和实验,而不能单靠演绎。长期以来,数学被视为这一判断的例外,是演绎科学的典范。但波利亚在《怎样解题》中指出,只有整理成定义、定理、证明之后的数学才呈现为演绎科学;数学家在发现过程中所做的工作,同样是归纳和实验。换言之,写在纸上的证明是一条从公理到结论的直线,而找到这条直线的过程,实质上是在一个巨大的空间中进行搜索:试错、类比、猜测、回退,直至某条路径走通,再将其整理成演绎的形式。从某种意义上说,数学家写作证明的过程,也是隐藏自己“思维链”的过程:省略试错与回退,只呈现整理后的逻辑。这就是笔者所说的“证明即搜索”。
从这一视角看,所谓数学家的直觉,本质上是关于“在何处搜索最可能有效”的判断,即搜索空间上的一个先验分布。而先验来自对以往搜索经验的压缩,因而是可以从文献中学习的。模型的先验同样主要来自人类写下的证明;就训练所用的证明数量而言,它远超任何个人。
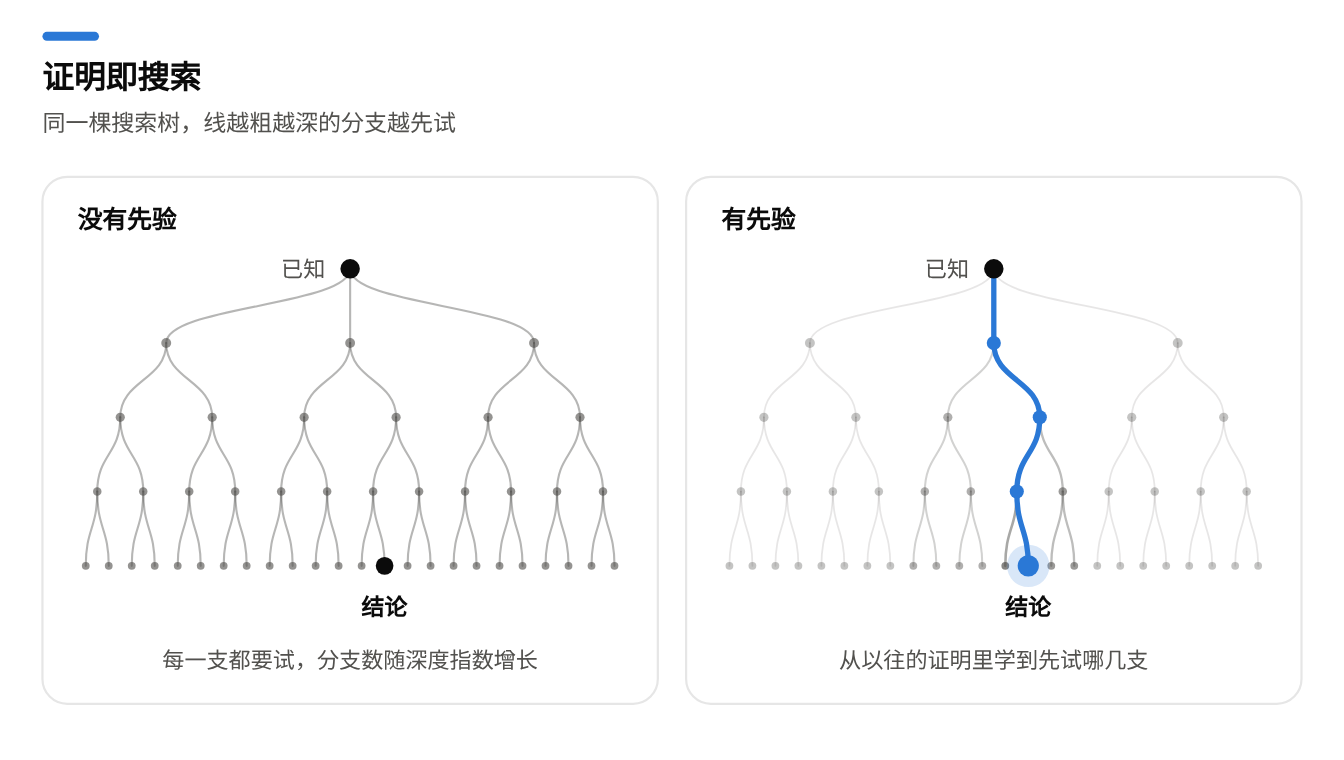
图 3 同一棵搜索树在有无先验时的搜索情况(示意)
因此,只要先验足够好、并行的计算足够多,搜索这件事就能够做好。围棋领域已经提供了证据:AlphaGo 的突破并非在于搜索得更深,而在于学到了足够好的策略与局面评估,也就是足够好的先验,使搜索不必遍历整个空间。数学的搜索空间更大,但在结构上属于同一类问题。
提出问题同样如此。提出好问题在形式上也是搜索,只是多了一个正则项:在所有可以陈述的命题中,寻找那些人类认为简洁、优雅、值得追问的命题。这种偏好同样蕴含在人类的数学文献之中,因而同样可以学习。综上,无论是完成证明还是提出问题,在原理上都没有障碍,剩下的只是规模和时间。
二、从社会认知看:智力稀缺性的消解
数学家所获得的社会尊重,有相当一部分来源于公众对非凡智力的敬畏:他们能够理解他人无法理解的概念,解决他人不知从何着手的问题。一条重大定理既是知识成果,也是个人能力的证明。
当计算系统能够以更低的成本、更高的速度反复给出这类结果时,这种联系就会断裂。
一位研究者借助人工智能发表了重要定理,人们自然会追问:问题是谁提出的?关键思路出自哪里?证明是谁完成的?如果后两问的答案都是模型的输出,那么论文上的署名就很难再承载过去那样的荣誉。
当然,人们仍然可以尊重教师的投入、研究者的诚实以及个人对知识的热爱。但由“极少数人才拥有的头脑”所带来的特殊地位,将会明显削弱。最先消退的,可能就是这样一种习惯:看到一项重大成果,便自然地将其作者视为非凡的天才。
Ilya Sutskever 在 2023 年曾写道:如果把智力看得高于人类其他一切品质,日子将会很难过。三年后重读,它像是写给数学家的。
围棋领域已经提供了一次预演。AlphaGo 之后,观众先看程序给出的胜率曲线,再评价棋手的落子是否正确;棋评从“某九段认为”变成了“AI 显示”。李世石退役时表示,即便自己是第一,也存在一个无法战胜的对手。但需要指出的是,职业围棋赛事仍在继续,因为它的社会基础是人与人之间的竞技。数学没有这样一条现成的退路:社会资助数学家,很大程度上是为了获得定理,而不是为了观看人类证明定理。围棋可以退回到体育,数学则需要另找理由。
三、从资源配置看:经费流向的变化
经费所受到的压力更为直接。
如果资助的目标是获得新知识,资助方就必须进行比较:支持一个团队研究多年,与购买模型和算力,哪一种方式更可能产出重要成果?
这一比较如今有了一个可以引用的数字:平均每个结果约三小时的算力。需要指出的是,这个数字的统计口径并不清楚:是否摊入了失败的尝试、模型训练和人工筛选问题的成本,发布方没有说明,因此不宜直接与一名研究者的年度经费相比。但量级上的差距已经足以让资助方提出这个问题。
当计算系统能够稳定地完成证明时,人类研究者就难以仅凭“这是一项重要的数学问题”来论证经费应当投向自己。问题的重要性只能说明它值得研究,并不能说明它必须由人来研究。
由此,单纯依靠定理产出来论证的岗位、博士名额和个人项目,将承受最直接的压力。预算调整未必在短期内完成,但推动调整的理由会先行出现。
与此同时,数学研究的总投入反而可能增加。政府和企业会投入更多资金用于购买算力、训练模型、建设证明验证系统。于是会出现一种过去不易想象的局面:数学得到了更多的钱,数学家得到的钱却可能更少。
翻译行业已经走过了这条路。机器翻译普及之后,全世界被翻译的文字总量空前增长,而职业译者的单价却持续下降,工作也越来越多地从翻译转变为审校机器译文。原因在于社会需要的是译文,而不是译者。
教学、人才培养、对机器产出的核验、取舍与消化、保持人类独立判断能力,都是值得资助的理由。但这些理由需要单独论证,不能因为数学仍然重要,就推断数学家的经费仍然稳固。把这套理由讲清楚,是数学共同体眼下最该做的事。
四、从知识传承看:可用与可理解
我们对数学的认识,可能尚处于相当早期的阶段。今天人类认为困难的问题,并不能决定它在更强的计算系统面前的难度。
当机器产出的新结果被用于下一轮搜索时,数学结果的增长速度和规模就可能远超人类的历史经验。在这种情况下,没有理由保证每一项重要成果都存在一个人能在有限生命内掌握的证明:有的成果需要过于庞大的知识准备,有的证明包含过多相互依赖的结构。人能够检查局部,却难以把握整体。让模型作出解释,可以得到摘要和比喻;但一份易于理解的说明并不等于理解了证明,真正困难的部分可能恰恰被摘要省略了。
这就引出一个应当正面回答的问题:没有人理解的知识,有什么用?
笔者以为,需要区分“可用”与“可理解”。一条经过形式化验证的定理,即使无人读懂全部论证,仍然可以作为引理被引用,可以进入工程和其他学科,这是它的“可用”。1976 年四色定理的计算机辅助证明问世时,曾引发长期争议,一个主要原因是其中大量计算无法逐项人工复核;今天它已被普遍承认,完整的形式化证明也已补上。
但“可用”的范围是有限的。其一,既没有形式化验证、也没有人读懂的结果,谈不上知识,只是待核对的文本——这一次公开的手稿中,就有一部分尚无形式化验证,仍需逐项核对。其二,一条定理只有被人理解,才能改变人看问题的方式,才能启发下一个由人提出的问题;无人理解的定理只能被机器再次调用,对人类数学的滋养是有限的。其三,哪些结果值得用、用在哪里,仍然要有人作出判断。
值得注意的是,发布方自己也承认理解的必要:OpenAI 在同一份公告中宣布,将资助一系列以“理解人工智能产出的重大结果”为主题的研讨会和专项计划。产出定理的一方,要出钱请人来理解定理。
还需要指出的是,通过了形式化验证,也不等于原定理就一定成立。从自然语言写成的定理到 Lean 中的命题,中间有一步翻译;Lean 检查的是翻译之后的命题。如果翻译时多加了条件、少了结论,或者改动了对象的定义,那么被证明的就不是原来那条定理。这一步目前主要靠人逐条核对。正确之外还有新颖与否的问题:据《科学美国人》报道,OpenAI 在 8 月公布的十个结果中,有两个被数学家质疑未充分注明已有工作的贡献。
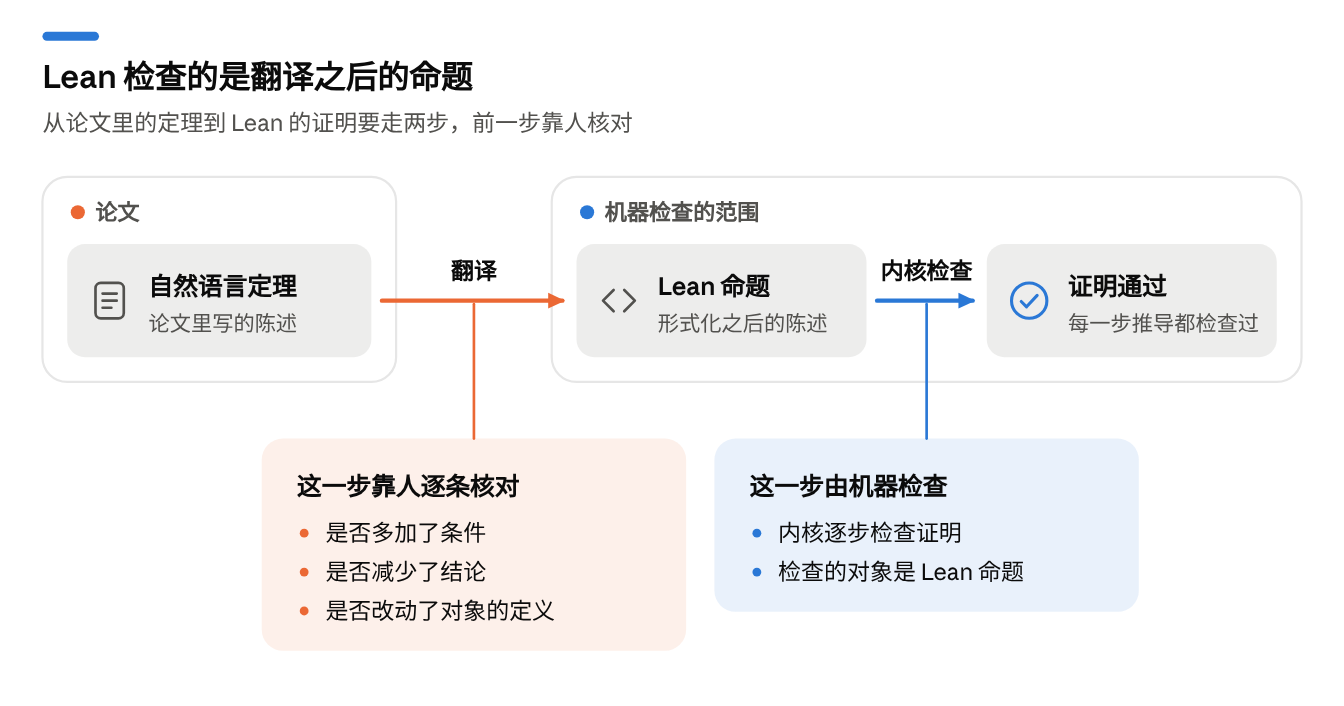
图 4 从论文里的定理到 Lean 证明的两步
一方面,人类的理解会落后于结果的增长,数学家对前沿知识的解释权将受到侵蚀;另一方面,核验与消化正在成为一项真实的、已有人承诺出资的人类职能。前者是压力,后者是机会。
五、从共同体的回应看:改变了发布方式,尚未改变速度
数学界已经开始作出回应。9 月 11 日,首批 25 位菲尔兹奖得主联署发表声明,指出解决问题只是达成概念理解的工具,批评人工智能公司匆忙宣布解答、不留时间整理方法,并警告如果没有数学家去消化和整合这些结果,数学家之间的传承链条将会断裂。次日公开亮相的“人类数学协会”(Association for Human Mathematics)要求其成员承诺不向商业人工智能公司提供技术劳动和咨询、不发表人工智能生成的数学文本。
就研究节奏而言,这些诉求的共同点,是希望人工智能公司等一等人类。
回应并非没有效果。9 月 21 日,设在普林斯顿高等研究院的“数学与人工智能咨询组”成立;10 月 6 日的发布参考了该组的公开建议,为部分手稿附上了形式化证明,并公布了过程材料和引用修订规则,发布方也承诺改进后续论文的引用与表述。就发布方式而言,协调的雏形已经出现。
但需要指出的是,被约束的是方式,不是速度。声明发表后第 25 天,722 篇手稿仍然公开。人工智能公司之间存在竞争,没有哪一家有理由单方面放慢;其他数学家也没有理由等待——下文将会谈到,抢跑对个人而言是理性的。要求所有人同时慢下来,需要一种比咨询组强得多的协调机制,目前并不存在。
这在某种意义上类似于两百年前的卢德运动。1811 年前后,英国的织袜工、剪绒工和织工发现工厂以新式机器和低薪工人取代了自己的手艺,于是在夜间成群捣毁机器。运动在几年内被镇压。“卢德派”后来成为反对技术进步的代名词,但这一用法对他们并不公平:他们对自身命运的判断是准确的,这些手工行当确实在此后几十年间衰落了。判断正确与阻止得了,是两件不同的事。
六、从竞争态势看:抢跑者先获利,职业整体付出代价
在这一过程中,数学家有很强的动力借助人工智能抢跑。
较早获得强模型的研究者,可能迅速完成他人需要多年研究的问题。由于贡献尚不透明,模型能力带来的产出会被记入个人能力,进而转化为职位、项目和荣誉。先用者受益,后来者被迫跟进。
如果一项工作随时可能被他人借助人工智能完成,坚持独立思考就意味着失去优先权的风险。只要首发仍然在很大程度上决定职业回报,研究者就很难按照自己认为理想的节奏工作。
这种压力还会改变学术交流的方式。一个尚未成熟的想法、一次报告中提出的猜想,都可能成为他人交给模型的研究任务。纳维–斯托克斯一事即是一例:纽约大学的 Tristan Buckmaster 称,OpenAI 是在有关他与合作者 Levent Alpöge 工作的消息传出之后才着手这一问题的;OpenAI 承认是在听到相关传闻后启动的,但否认在对方公开之前接触过他们的工作。此事真相尚无定论,但它已经足以让研究者在公开思路之前多想一步。公开得越早,越可能失去后续成果;有人会更加保密,也有人会抢先发布粗糙的想法,只为留下时间记录。
当使用人工智能成为常态,竞争将进一步转向更强模型的访问权、更多的算力以及批量探索问题的能力。产出这 722 篇手稿的模型至今没有对外开放。这些资源若集中于少数机构,数学研究的竞争就会更多地依赖机构实力而非个人。
而随着模型的贡献越来越难以忽视,论文产出与个人智力之间的联系会越来越弱。最早借助人工智能赢得荣誉的人,恰恰参与加速了数学家传统声望依据的瓦解。个人抢跑可以是完全理性的;但所有人都这样做,仍然可能导致整个职业议价能力的下降。
七、关于“人类负责提问”的辨析
一种常见的说法是:人工智能负责证明,人类负责提出问题。
就目前而言,这是事实,而不只是安慰。这一次批量公开的结果,据发布方披露,都是从人给定的未解问题出发的;猜想比证明更能决定一门学科的走向,这一点笔者是同意的。
笔者想提醒的只是,不宜把它当作永久的分工。提出好问题需要掌握已有理论,看到其中的缺口,判断哪些方向可能产生重要联系。如果计算系统在前沿问题上的解题表现持续超过人类,那么它在“哪些问题值得做”上给出的候选和排序,迟早也会被拿来与人的判断相比较。评价成果亦是如此:定理被大量生成之后,筛选和判断会变得更重要,但这并不意味着它们必然由人来完成。
解释和方向选择,都不能仅仅因为过去由人承担,就被视为人类永久保留的职责。国际象棋提供了一个参照:深蓝之后的十多年里曾有一段时间,“人加引擎”的组合胜过纯引擎,人们据此相信人机协作是长期出路;但这个窗口后来还是关闭了。按第一节的分析,数学没有理由成为例外。
因此,数学家需要回答一个具体的问题:在同样的资源条件下,自己的参与究竟增加了什么?今天的答案是清楚的:提问,以及对结果的核验、取舍与消化。其中提问一项能保持多久,取决于技术;后三项能否保住,取决于数学共同体是否有意识地去经营。
结语
这份悲观背后,其实是一个问题。数学从来有两面:一面是定理,一面是数学家,是理解一个证明时的喜悦,也是从老师到学生的传承。人工智能正在使前一面的增长远远超出我们的历史经验,后一面将如何延续,却还没有清楚的答案。
至少在今天,数学审美仍是人工智能与人类之间的一处差距。面对许多正确的结果,数学家会选择其中少数反复讲述,因为它们让我们看到了更深的联系,或者教会了我们一种新的思考方式。这种选择塑造了我们今天所认识的数学。
我们无法保证这份差距永远存在。但在机器不断拓展数学边界的时候,人类仍然需要理解自己为什么喜爱数学,又希望把怎样的数学留给下一代。如果有一天,所有问题都有了答案,我们是否还保有辨别哪些答案值得珍视的眼光?
参考来源
• [1] OpenAI. Sharing AI progress in mathematics. 2026 年 10 月 6 日。
• //openai.com/index/sharing-ai-progress-in-mathematics/
• [2] OpenAI. openai/math 数学手稿与形式化证明仓库. GitHub,访问日期 2026 年 10 月 7 日。
• //github.com/openai/math
• [3] OpenAI. On the Navier–Stokes Millennium Prize Problem. 2026 年 9 月 8 日。
• //openai.com/index/navier-stokes-solution/
• [4] Joseph Howlett. OpenAI claims blockbuster math breakthrough amid swirl of controversy. Scientific American,2026 年 9 月 8 日。
• //www.scientificamerican.com/article/openai-claims-blockbuster-math-breakthrough-amid-swirl-of-controversy/
• [5] Zhewei Wei. Tight Bounds for Tusnády’s Problem in the Plane. arXiv:2610.08130,2026 年 10 月 6 日。
• //arxiv.org/abs/2610.08130
• [6] Isabella Ward. ‘I’m Really Terrified’: A Mathematician Grapples With AI’s Recent Breakthroughs. WIRED,2026 年 9 月 12 日。
• //www.wired.com/story/mathematician-steven-strogatz-grapples-with-ai-recent-breakthroughs/
• [7] Steven Strogatz. Wimbledon, the U.S. Open, and the future of mathematics. Terence Tao 博客客座文章,2026 年 9 月 12 日。
• //terrytao.wordpress.com/2026/09/12/wimbledon-the-u-s-open-and-the-future-of-mathematics/
• [8] Math and AI. A Severe Misalignment of AI in Mathematics. 数学家联署声明,2026 年 9 月 11 日。
• //mathandai.org/
• [9] AHM communications group. The Association for Human Mathematics. Proofs and Prompts,2026 年 9 月 12 日。
• //proofsandprompts.com/2026/09/12/the-association-for-human-mathematics/
• [10] Advisory Group on Mathematics and Artificial Intelligence. Responsible Release of AI-Generated Mathematics. 2026 年 9 月 29 日。
• //agmai.org/general-sep29/
• [11] Advisory Group on Mathematics and Artificial Intelligence. 数学与人工智能咨询组官方网站及建议文件. 含 On OpenAI’s Release of Mathematical Results,2026 年 10 月 6 日。
• //agmai.org/
• [12] Ilya Sutskever. if you value intelligence above all other human qualities, you’re gonna have a bad time. X,2023 年 10 月 6 日。
• //x.com/ilyasut/status/1710462485411561808
• [13] Nikhil Bansal. Discrepancy theory and related algorithms. ICM 2022 报告文章,第 1.2.4 节,DOI: 10.4171/ICM2022/169。
• //ems.press/books/standalone/279/5596